說話聲,單獨一條
01 / 對白清理
從嘈雜錄音裡提取人聲
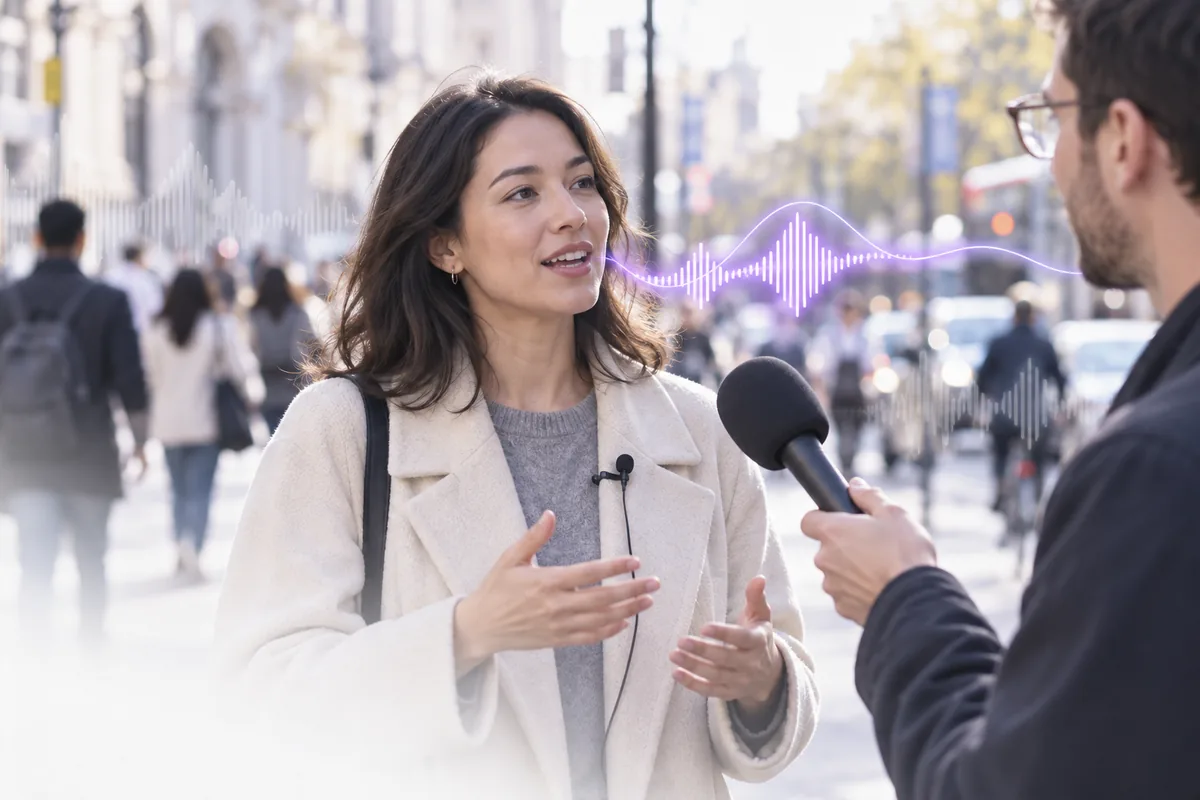
車流、風聲、人群,或者墊在說話聲下面的音樂,人聲提取會把說話聲單獨放到一條音軌上,適合影片對白、Podcast 和採訪。
- 嘈雜影片裡的對白
- 在吵鬧環境裡錄的採訪
- 背景聲另存為第二個檔案
上傳一段錄音,AI 會把人聲單獨提出來:街頭噪音裡的對白,或樂隊伴奏裡的歌聲。
先在這裡試聽檔案。點選開始後,檔案會私密上傳,由伺服器上的 AI 模型完成分離,可能需要幾分鐘。價格按音訊時長計算,開始前會顯示在按鈕上;分離失敗會自動退回點數。分好的每條音軌都能在這裡試聽、下載,之後也可以在生成記錄裡找到。
單個檔案最多 50 MB、10 分鐘 · 每分鐘 20 點數(不足 1 分鐘按 1 分鐘計,最少按 2 分鐘計)
或把檔案拖到這裡
MP3、WAV、M4A、FLAC 等常見音訊格式點選開始後才會上傳檔案。只有你的帳號能開啟它,檔案只會交給負責分離的 AI 模型服務供應商處理。
歌曲、採訪或Podcast音訊,先在頁面上試聽。
登入後開始,每分鐘 20 點數,最少計 2 分鐘。
人聲一條,剩下的背景聲另存一條。
車流、風聲、人群,或者墊在說話聲下面的音樂,人聲提取會把說話聲單獨放到一條音軌上,適合影片對白、Podcast 和採訪。
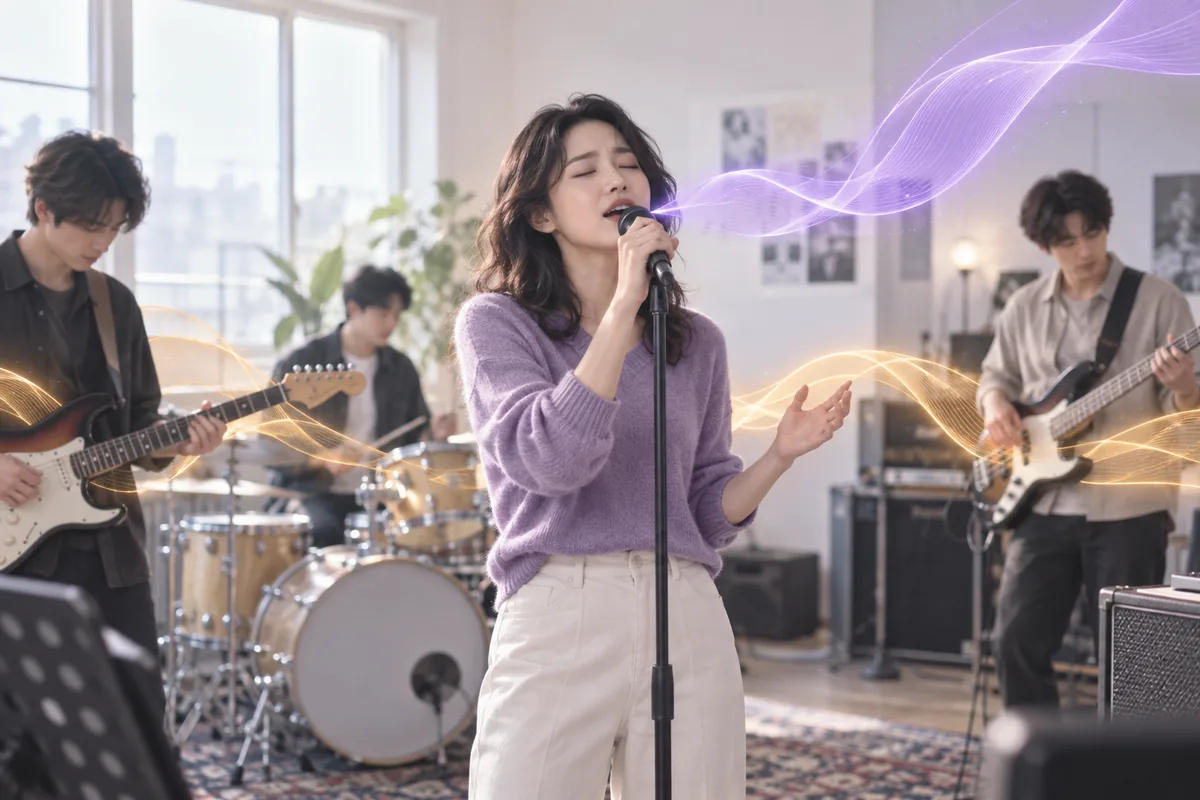
處理歌曲時,人聲提取會把歌聲從樂隊裡分出來。清唱可以拿去做混音、取樣或扒旋律,伴奏作為第二個檔案一起給你。
聲音克隆會連噪音一起學。手上只有帶音樂或底噪的錄音時,先提取人聲,再拿乾淨的人聲做參考音訊。
說話聲也好,歌聲也好,下面這些場景都需要單獨的人聲。
在風大的街頭或熱鬧的活動現場拍的影片,先把對白提取出來,再在剪輯軟體裡重新配樂或鋪環境聲。
遠端採訪錄進了電視聲或咖啡館的嘈雜聲,提取人聲後對話更容易聽清,也更方便整理文字稿。
把歌裡的人聲提出來做混音、串燒或採樣,再用調性檢測和 BPM 檢測工具把兩首歌對齊。
錄好的課程和講座裡混進了投影儀風扇聲、走廊噪音或背景音樂,提取人聲後講解更清楚。
克隆自己的聲音之前先清理參考音訊,讓模型學到的是你的音色,而不是房間回聲或背後的歌。
把更乾淨的人聲交給語音轉文字或字幕工具,背景噪音常常是漏字和錯字的原因。
降噪濾鏡擅長穩定的底噪,重錄最乾淨卻常常做不到,AI 人聲提取適合兩者之間的情況。
| 對比項 | AI 人聲提取 | 降噪濾鏡 | 重新錄音 |
|---|---|---|---|
| 能去掉什麼 | 音樂、人群等非人聲 | 穩定的嘶聲、嗡聲和風扇聲 | 不去,直接重錄一遍 |
| 說話下的音樂 | 分到背景聲檔案裡 | 大多會留下,它不是穩定噪聲 | 錄音時不放音樂就行 |
| 需要準備 | 登入後上傳檔案即可 | 外掛或軟體,加一段噪聲樣本 | 人、場地和裝置都要重來 |
| 副作用 | 極嘈雜的素材可能有瑕疵 | 降得太狠聲音發悶發虛 | 語氣和節奏可能和原來不同 |
| 額外得到 | 背景聲作為第二個檔案 | 只有處理後的音訊 | 一條新錄音,不是原來那一刻 |
| 最適合 | 嘈雜對白、採訪和清唱 | 本身乾淨的錄音去點底噪 | 可以重新錄的台詞 |
人聲本身越清楚,提取效果越好。上傳前後留意下面幾件事。
上傳相機或錄音筆裡的原始檔案,別用聊天軟體轉發過的版本,它們已經被壓縮過。
要清理影片裡的對白,先在剪輯軟體裡匯出音軌,存成 WAV 或高位元速率檔案再上傳。
人聲提取分的是人聲和背景,不是把不同的人分開,兩人同時說話會留在同一條軌上。
提取後的人聲聽著太乾、太空時,把背景聲檔案小音量混回去一點,會自然很多。
空曠大房間的回聲和人聲粘在一起,提取後的人聲裡可能還帶著一點房間感。
發布前重點聽最吵的片段。呼吸聲、字尾和輕聲的地方,最容易先聽出瑕疵。
關於人聲提取、能得到什麼,以及檔案如何處理。
人聲提取也叫提取人聲或去背景音,是用 AI 把錄音裡的人聲和其他聲音分開,比如音樂、車流、人群或房間裡的嗡聲。你會得到一條人聲和一條剩下的背景聲,都可以下載為音訊檔案。
現在就能用。選擇檔案並試聽免費,AI 人聲提取需要登入並消耗點數,每分鐘音訊 20 點數,按分鐘向上取整,最少按 2 分鐘計,失敗自動退回。點數來自價格頁的方案和點數包。
用 AI 人聲提取把錄音拆成人聲和背景聲兩條音軌。在上方選擇錄音檔案試聽,登入後點選開始,檔案會上傳並交給 AI 模型處理。之後想把兩條重新混合,可以用線上混音工具。
看你要留下哪一個。人聲提取是為了留下人聲,比如採訪、影片對白和做混音用的清唱;去人聲是為了留下伴奏,比如 K 歌和翻唱。兩者都會給你兩個檔案。
能,但要先把影片的音軌匯出來:在剪輯軟體或手機上匯出音訊,上傳後提取人聲,再把乾淨的人聲放回時間線,和畫面對齊。
不完全一樣。降噪濾鏡學習一段穩定的噪聲,比如嘶聲或風扇聲,再把它減掉,說話聲下面的音樂和嘈雜人聲大多會留下。AI 人聲提取學的是人聲的樣子,把人聲和其餘所有聲音分開,音樂也包括在內。
可以,手上只有帶音樂或噪音的錄音時尤其有用。先提取人聲,再把乾淨的人聲作為聲音克隆的參考音訊。條件允許的話,在安靜房間重新錄一段仍然最好,而且只能克隆你本人或已授權的聲音。
開始 AI 分離後,檔案會上傳到我們的伺服器和 AI 模型服務供應商,只用於處理你的這次請求。檔案如何儲存和處理,以隱私政策為準。請只上傳你有權使用的錄音。
現在就選一段錄音,登入後提取乾淨的人聲。